豆包刚刚宣布了, 要把Kimi 3.1 Pro和GLM 5.3这两样东西接入进去, 在AI办公这个方面, 就不再是只有一家公司占着大块市场了, 想选用哪家的模型就可以挑哪家的情况, 现在已经真的出现了。
多模型同框办公
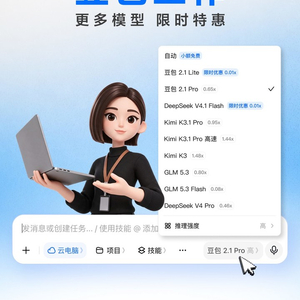
在11月12日的时候, 豆包工作这一项服务向大家宣布说, 他们决定把Kimi 3.1 Pro、GLM 5.3、V4.1 Flash等等多款由第三方提供的模型, 都接入到这里面来。
现在用户的话, 只需要在一个平台里面进行操作的这个过程里, 就可以随意切换使用不同厂商做出来的AI了, 根本就不用再像以前那样去反复开设和打开好几个网页来应付不同的事情了。
在此前, 企业客户已经能够去调用第三方的模型, 而这次是干脆直接面向所有的用户开放, 使得门槛变得更为低了下去,而且对日常办公场景的覆盖也变得更广了。
额度倍率透明化
平台对展示的方式进行了调整, 在模型选择页面直接标注了每一款模型的额度消耗倍率。倍率越低就代表单次调用的费用越低廉, 让用户可以很直观地看清楚具体的成本需要多少。
官方同步进行了下调操作, 调整的标的是豆包2.1 Lite倍率以及V4.1 Flash倍率, 执行同样的任务, 所要花费的额度会变少一些, 高频用户的月度成本, 会有明显的下降。
限时优惠拉低成本
这个新推出来的优惠计划, 它覆盖了工作日以及节假日的指定时间段。要是用户使用参与这个活动的模型, 那么还能再省下一些额度的钱。这种安排对学生用户来讲, 是非常友好的。同时, 对于那些轻量的办公场景, 也显得十分合适。
把那个倍率进行叠加, 随后这个倍率就会向下调整, 这样一来, 对于整体使用的门槛来说就进一步降低了, 那些重度用户在一周的时间范围之内, 能够比别人多出一些来完成的任务, 而且这样做的话, 并不需要花费更多的钱。
任务匹配选模型
编程的时候应该选择逻辑能力比较强的模型, 写文档的时候适合选用响应速度更快的模型, 而在做数据分析这种任务时, 最好是选择能够处理长上下文的模型。目前的豆包工作这个平台, 把具体的选择权重新交回到用户的自己的手里, 让使用者可以根据实际的需求来进行灵活的搭配。
这个情况是完全不同于以前所采用的那种用一个模型来应对所有任务的方式的。实际上的效率是非常取决于你所分配的具体的任务的性质的, 也就是说要配合上对应的模型来进行处理的。这样的方式的灵活度是有了非常大的提升的。
平台竞争逻辑变了
现在单一模型的能力上限是越来越清楚了, 大家竞争的着力点正在发生转移, 转而去看一看你能调控多少个模型, 以及能不能把成本给压上去。
豆包采取的是开放路线这种做法, 这相当于就是把模型货架直接摆出来, 从而让用户可以进行自主挑选, 平台所赚取的主要是工作流黏性这个层面的收益, 而不是说依靠对单个模型的溢价能力来获取利润。
对普通用户意味着什么
最直接的好处在于, 使用者不再需要去分别注册多达五六个的AI账号, 只需要依靠一个豆包就能把所有的任务都处理好。其中Kimi在处理长篇幅的文章方面具有优势, 而GLM则在编程代码方面表现得更为强大, 用户可以根据自身的实际需求来选择合适的工具。
你需要注意到, 不同的模型在额度消耗方面的差异是非常大的。所以在动手进行操作之前, 一定要把倍率看清楚。千万不要拿着最贵的模型去跑那些任务量很轻的工作, 因为这样做会造成额度的严重浪费。
你现在在豆包工作里, 是拿Kimi来跑一些什么具体的任务呢, 还是说继续死守着deepseek, 根本不打算换模型了, 大家可以在评论区聊聊你的看法, 顺手点个赞让更多人看到你的内容。